Diyelim ki elinde 10 milyon elemanlık devasa bir veri listesi var. Bu listenin en sonundaki bir elemana ulaşmak ya da o elemanın orada olup olmadığını kontrol etmek istediğinde, bilgisayarın listeyi en baştan en sona doğru tek tek taramak zorundadır. Bu işlem yazılım dünyasında O(N) zaman karmaşıklığı olarak adlandırılır ve listeniz büyüdükçe sisteminizi hantal bir kaplumbağaya dönüştürür. Ancak Python'da öyle bir veri yapısı vardır ki, içeride 10 milyon değil 10 milyar veri dahi olsa, aradığınız bilgiye milisaniyeler içinde, adeta nokta atışı yaparak ulaşır. Bu işlem ise O(1) yani sabit zaman karmaşıklığı olarak bilinir. İşte bu inanılmaz hızın arkasındaki gizli kahraman, Python’ın en güçlü ve büyüleyici veri yapısı olan Dictionary (Sözlük) mimarisidir!
Peki sözlükleri sadece "süslü parantez içine yazılan anahtar-değer (key-value) çiftleri" olarak mı görmeliyiz? Kesinlikle hayır. Python'ın sözlük dünyasına derinlemesine indiğinde, arkada dönen ve her veri aramasını bir kuantum sıçramasına dönüştüren Hash Tablosu (Hash Table) algoritmasını, benzersiz bir şifreleme ve adresleme dehası olan hash fonksiyonlarını, iki farklı verinin aynı adrese çarpmasıyla oluşan çatışma (collision) savaşlarını ve Python 3.6 ile gelen, bellek tüketimini yarı yarıya düşüren o meşhur "Compact Dict" devrimini görürsün. Bu rehberde; sıkıcı ve teorik tanımları tamamen bir kenara bırakıyoruz. Anahtar-değer ilişkisinin donanım arkasındaki yaşam döngüsünden hash çatışmalarının RAM'deki kriz anlarına, sözlüklerin id() bazlı bellek izlerinden Pythonic dictionary comprehension’ların mikro-performans dehasına kadar Python sözlüklerinin anatomisini bir bilgisayar mimarı gibi inceliyoruz!
1. Python Sözlüğünün Kalbi: Hash Tablosu (Hash Table) Felsefesi
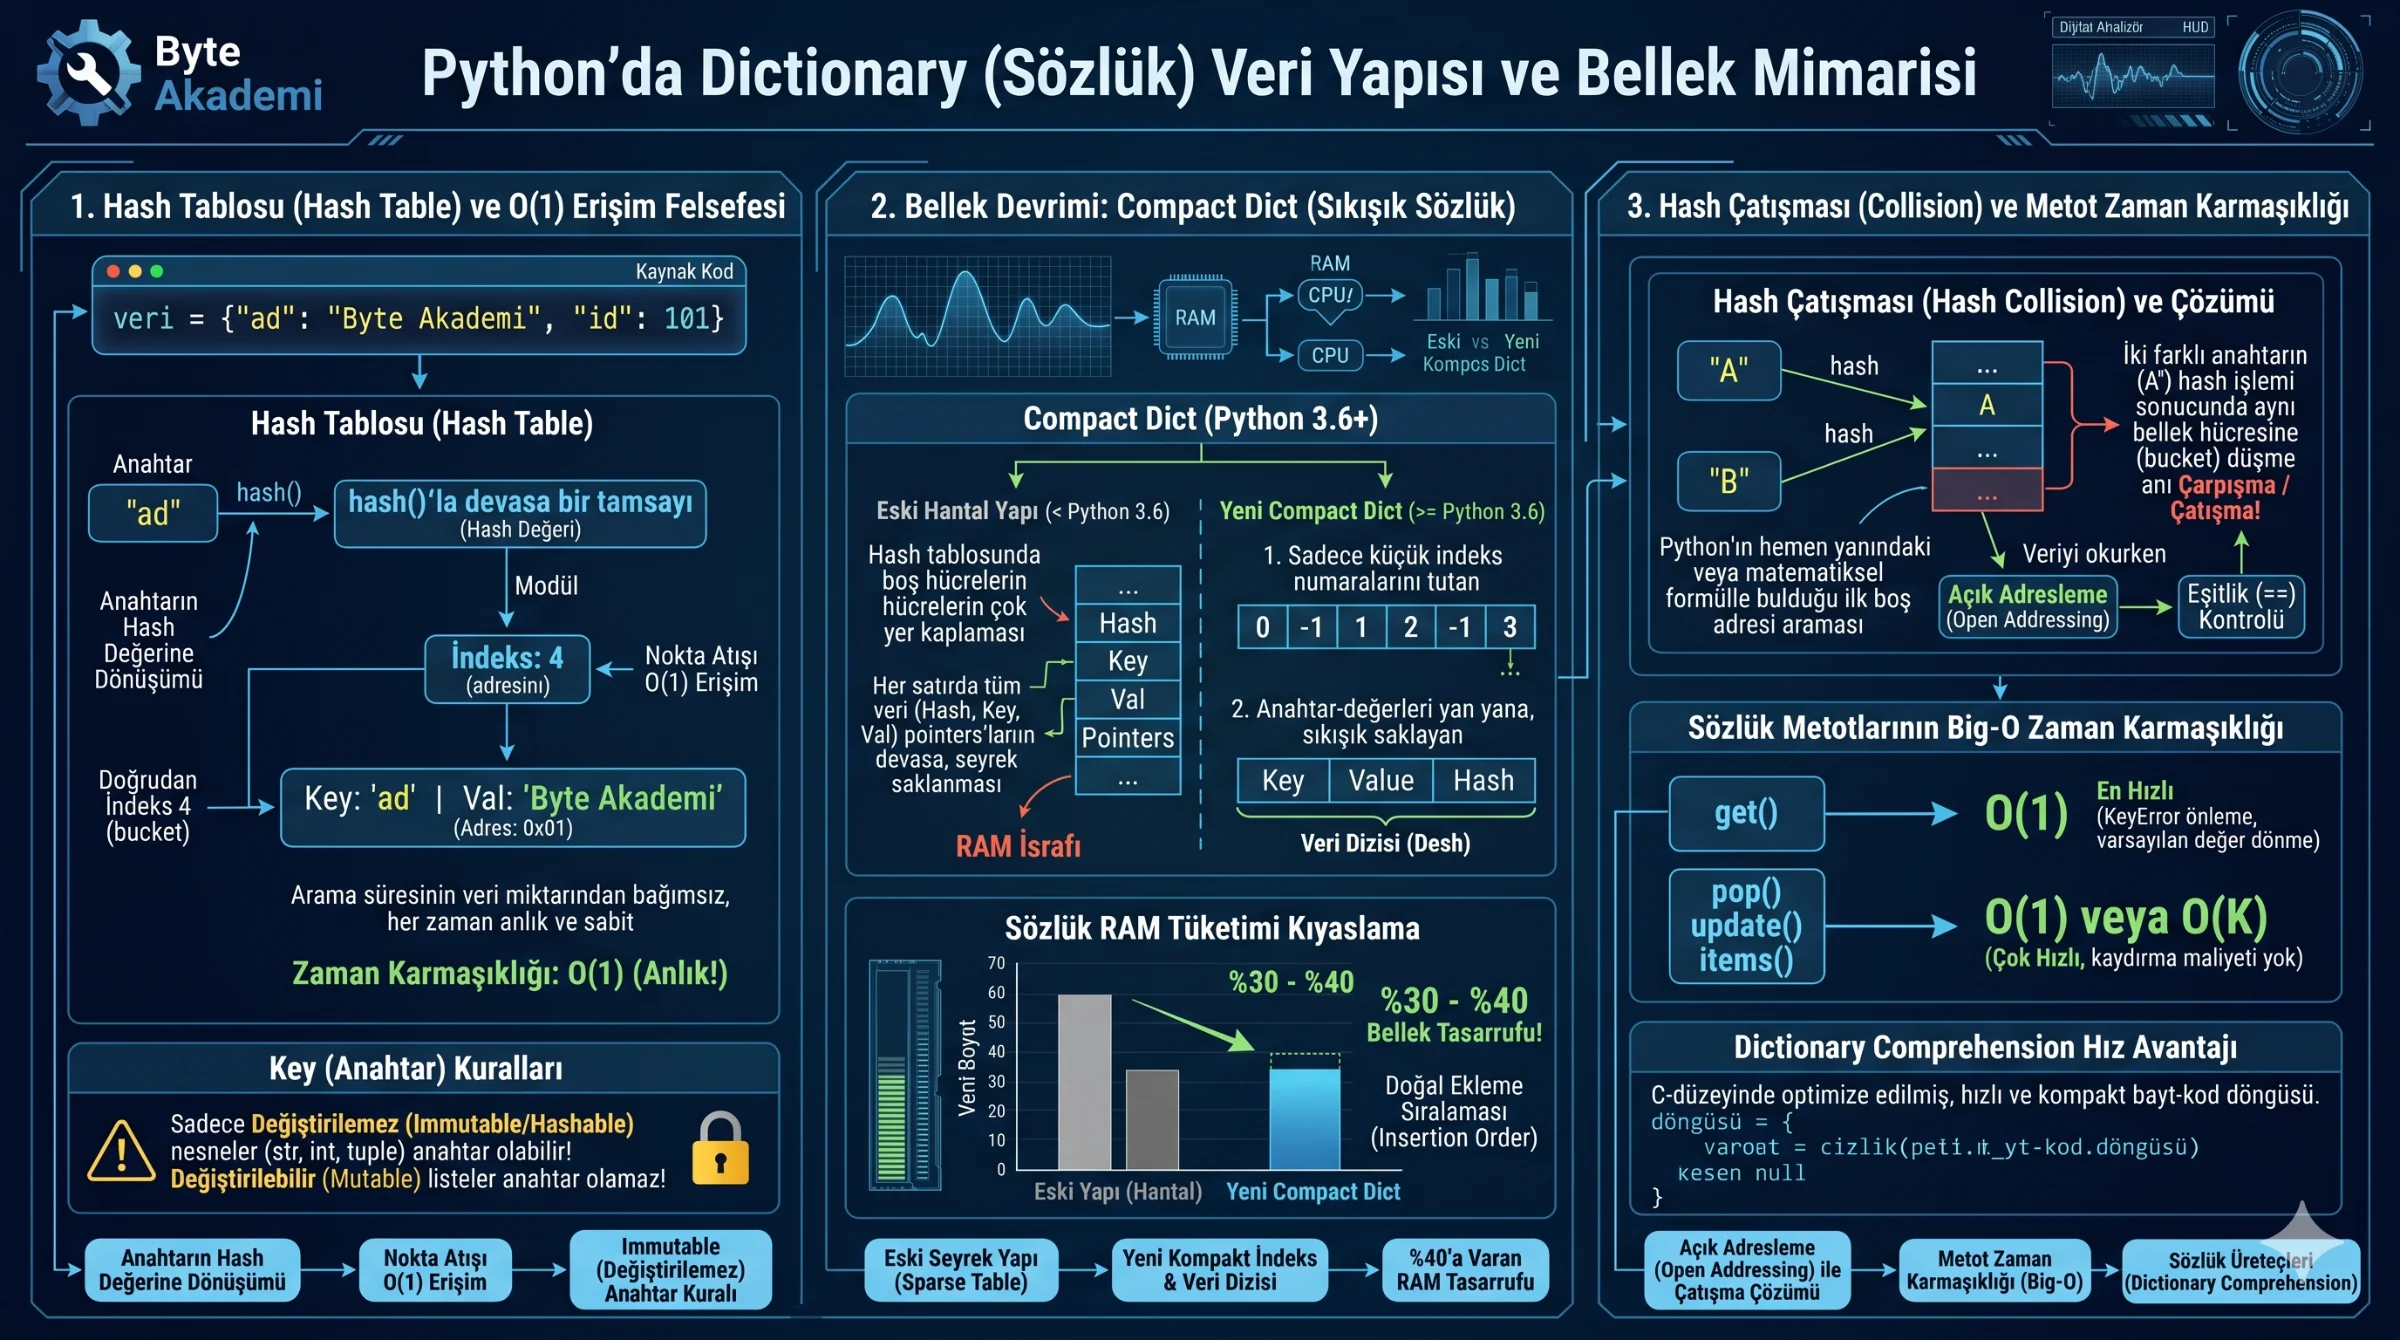
Python'da bir sözlük tanımladığında (veri = {"ad": "Byte Akademi", "id": 101}), bu anahtarlar ve değerler belleğe rastgele ya da sırayla fırlatılmaz. Her bir anahtar-değer çiftinin RAM'deki adresi, sarsılmaz bir matematiksel dönüşümle, yani Hashing (Karma) fonksiyonu ile belirlenir.
Arka planda CPython düzeyinde işletilen süreç tam olarak şudur:
- Hash Hesaplama: Python, verdiğin anahtarın (örneğin
"ad"metninin) üzerinden özel birhash()algoritması çalıştırır ve onu devasa bir tamsayıya (hash value) dönüştürür. - İndeks Belirleme: Elde edilen bu büyük sayı, sözlüğün arka plandaki fiziksel adres tablosunun (hash table) boyutuna bölünerek (modül işlemiyle) bir indeks numarasına indirgenir.
- Nokta Atışı Erişim: Python'a "ad" anahtarını sorduğunda, sistem tüm sözlüğü taramaz. Doğrudan "ad"ın hash değerini hesaplar, ilgili indeksteki bellek hücresine (bucket) zıplar ve değeri oradan anında söker alır. İşte bu yüzden arama süresi veri miktarından bağımsız olarak her zaman O(1) (anlıktır).
  [PYTHON DICTIONARY HASH TABLOSU ANATOMİSİ]

  "ad" Anahtarı ---hash()---> Devasa Tamsayı ---Modül---> İndeks: 4
                                                            │
                                                            ▼
                                                     [ Hash Tablosu ]
                                                     [ 0 ] [ Boş ]
                                                     [ 1 ] [ Boş ]
                                                     [ 4 ] ───> [ Key: "ad" | Val: "Byte Akademi" (0x01 Adres) ]
                                                     [ 7 ] [ Boş ]
Büyük Güvenlik Kuralı: "Hashable" Olmak Zorunlu! Bir nesnenin bir sözlükte "anahtar" (key) olabilmesi için kesinlikle değiştirilemez (immutable) olması gerekir (string, integer, float, tuple gibi). Çünkü eğer anahtar değiştirilebilir (mutable) bir nesne (örneğin bir liste) olsaydı, içeriği değiştiğinde hash değeri de değişirdi. Bu durumda Python, o anahtarın bellekteki yerini bir daha asla bulamazdı ve bellek bütünlüğü tamamen çökerdi! Bu yüzden listeler sözlüğe anahtar olamaz, ancak değer (value) kısmında her türlü veri tipi serbestçe yaşayabilir.
Python'da bir sözlüğe erişmek tüm veriyi tarayan bir arama değil; anahtarın hash değeri üzerinden doğrudan ilgili bellek adresine zıplayan milisaniyelik bir kuantum atlamasıdır.
2. Bellek Devrimi: "Compact Dict" ve RAM Tasarrufu
Python 3.6 öncesinde sözlükler RAM'de oldukça fazla yer kaplayan hantal yapılardı. Çünkü hash tablosunun her bir satırında anahtarın hash'i, anahtar nesnesinin adresi ve değer nesnesinin adresi doğrudan birlikte tutuluyordu ve tablonun büyük kısmı boş (boşa harcanan RAM) kalıyordu.
Python 3.6 ve sonrasında ise CPython geliştiricileri Compact Dict (Sıkışık Sözlük) mimarisine geçiş yaptı:
- İndeks Dizisi: Bellekte sadece indeks numaralarını tutan çok küçük ve kompakt bir tam sayı dizisi (array) oluşturuldu.
- Veri Tablosu: Esas anahtar-değer çiftleri ise bellekte yan yana, sıkışık ve sıralı bir "veri tablosu" (dense array) içinde depolandı.
Bu dahice tasarım sayesinde sözlüklerin RAM tüketimi %30 ila %40 oranında azaldı ve en önemlisi, Python sözlükleri artık eklenme sırasını (insertion order) doğal bir şekilde korur hale geldi!
3. En Çok Kullanılan Sözlük Metotları ve Zaman Karmaşıklığı (Complexity)
Bir sözlükle çalışırken kullanacağın metotların işlemci üzerindeki maliyetlerini bilmek, yazılımının performansını zirvede tutmanı sağlar:
| Metot / İşlem | Mühendislik Görevi | Örnek Kullanım | Zaman Karmaşıklığı (Big-O) | Performans Etkisi |
|---|---|---|---|---|
| get() | Anahtarı arar, yoksa hata vermek yerine varsayılan (None) değer döner. | veri.get("yas", 0) |
O(1) (En Hızlı) | KeyError hatası alarak programın çökmesini engellemenin en güvenli yoludur. |
| update() | Sözlüğe başka bir sözlükten verileri topluca ekler veya günceller. | veri.update({"yas": 28}) |
O(K) (Hızlı) | Tek tek atama yapmaktan çok daha verimli ve toplu bir işlemdir. |
| pop() | Belirtilen anahtarı ve değerini sözlükten siler ve o değeri döner. | yas = veri.pop("yas") |
O(1) (Anlık) | Anahtarı silerken değeri de kurtarır; kaydırma maliyeti yoktur. |
| keys() / values() | Tüm anahtarları veya tüm değerleri dinamik bir görünüm (view) olarak döner. | veri.keys() |
O(1) (Hafif) | Bellekte yeni bir liste oluşturmaz, doğrudan mevcut verinin görünümünü sunar. |
| items() | Tüm anahtar-değer çiftlerini tuple (demet) çiftleri halinde döner. | veri.items() |
O(1) (Verimli) | Döngülerde (for) anahtar ve değeri aynı anda taramanın en Pythonic yoludur. |
4. Hash Çatışması (Collision) Nedir? Savaşın Perde Arkası
Fiziksel dünyada her ne kadar mükemmel matematiksel fonksiyonlar kullansak da, bazen tamamen farklı iki anahtarın (örneğin "anahtarA" ve "anahtarB") hash hesaplamaları ve modül işlemleri sonucunda **aynı bellek indeksine (bucket)** düşmesi kaçınılmazdır. Bu kaçınılmaz doğa olayına Hash Çatışması (Hash Collision) denir.
Python bu kriz anını çözmek için son derece gelişmiş bir **Açık Adresleme (Open Addressing / Quadratic Probing & Linear Probing)** algoritması işletir:
- Çatışma Tespiti: Python, hesaplanan indeks hücresinin zaten dolu olduğunu görür.
- Yeni Adres Arayışı: Python hemen pes etmez; özel bir matematiksel formülle (quadratic/linear probing) "bir sonraki müsait boş hücre nerede?" diye taramaya başlar.
- Kayıt ve Doğrulama: Boş bir hücre bulduğunda veriyi oraya yazar. Veriyi geri okurken ise, o adresteki anahtarın gerçekten aranan anahtar olup olmadığını "equality" (
==) kontrolü ile doğrular. Çatışmalar arttıkça O(1) olan erişim süresi hafifçe O(N)'e doğru bükülebilir; bu yüzden Python, doluluk oranı %66'ya (load factor) ulaştığı anda hash tablosunu otomatik olarak büyüterek çatışmaları her zaman minimumda tutar.
5. Pythonic Zirve: Dictionary Comprehension Optimizasyonu
Tıpkı listelerde olduğu gibi, sözlük üretirken de klasik döngüler yerine tek satırlık, C-seviyesinde optimize edilmiş **Dictionary Comprehension** yapısını kullanmalısın. Bu, kodunun okunabilirliğini ve çalışma hızını ciddi ölçüde artırır:
# Geleneksel Hantal Yöntem: 5 Satır
kareler = {}
for x in range(5):
    if x % 2 == 0:
        kareler[x] = x ** 2

# Pythonic Optimize Yöntem: Tek Satır!
kareler = {x: x ** 2 for x in range(5) if x % 2 == 0}Eğer sözlükte var olmayan bir anahtara sürekli ekleme veya sayma işlemi yapıyorsan, sürekli if key not in dict kontrolü yapmak kodunu hantallaştırır. Bunun yerine Python'ın yerleşik collections modülündeki defaultdict (varsayılan değerli sözlük) veya Counter (otomatik sayıcı) yapılarını kullanmalısın. Bu özel sınıflar, arka planda C-seviyesinde optimize edilmiş algoritmalar çalıştırarak büyük verilerdeki arama ve ekleme sürelerini minimuma indirir.
Sözlükler, sadece verileri depolayan süslü parantezli yapılar değildir; Heap'teki binlerce değiştirilemez nesneye hashing algoritmasıyla milisaniyeler içinde doğrudan erişim sağlayan çok güçlü birer bellek mimarisidir. get()'in güvenli arama konforundan hash çatışmalarının çözülme mantığına, Compact Dict'in bellek tasarrufundan Dictionary Comprehension’ların C-düzeyindeki hızına kadar her mekanizmayı kavramak, seni alelade bir kodlayıcıdan sarsılmaz, yüksek hızlı ve büyük ölçekli sistemler inşa eden bir mühendise dönüştürür.