Selam teknoloji ve mühendislik tutkunu dostum! Hiç cep telefonunun kamerasını arızalı bir elektronik devre kartına veya karmaşık bir matematik denklemine tutup, yapay zekayla tıpkı yanındaki kıdemli bir mühendis arkadaşınla konuşuyormuş gibi sesli sohbet ederken "Bu sistem benim sesimi, kameradaki canlı görüntüyü ve ekrandaki kodu aynı anda nasıl tek bir beyinde birleştiriyor?" diye düşündün mü? Dışarıdan bakıldığında her şey sihir gibi görünür; ama kaputun altına indiğimizde karşımıza son on yılın en büyük bilgi işlem devrimi çıkar!
Yıllar boyunca piyasadaki pek çok yapay zeka modeli aslında "yama işi (Frankenstein)" mimarilerle çalıştı. Yani ortada sadece metin okuyan kör ve sağır bir dil modeli vardı; sen ona bir fotoğraf gösterdiğinde önce harici bir görüntü okuma modeli resmi kelimelere çeviriyor, ses gönderdiğinde ise ayrı bir ses-metin (Speech-to-Text) çeviricisi konuşmanı düz yazıya döküp ana modele iletiyordu. Peki bu "kulaktan kulağa" oyununda ne kayboluyordu? Sesindeki endişeli vurgu, videodaki milisaniyelik bir kıvılcım veya diyagramdaki iki çizginin birbirine olan geometrik açısı! İşte Google DeepMind mühendisleri, Google Gemini mimarisini tasarlarken bu eski yama yöntemini tamamen çöpe attı ve "Doğuştan Çok Modlu (Natively Multimodal)" adını verdiğimiz yepyeni bir sinir ağı fiziği inşa etti. Kahveni al ve arkana yaslan; çünkü bugün kelimelerin, piksellerin ve ses dalgalarının aynı matematiksel uzayda nasıl dans ettiğini birlikte çözeceğiz!
1. "Sonradan Yamalı" Modeller vs. "Doğuştan Çok Modlu" (Native Multimodal) Mimari
Bir yapay zekanın "Doğuştan Çok Modlu" olması ne demektir, gel bunu çok somut bir mühendislik benzetmesiyle netleştirelim: Eski nesil yapay zekalar (Modüler / Cascaded sistemler), birbirinin dilini bilmeyen üç ayrı uzmanın (bir edebiyatçı, bir fotoğrafçı ve bir ses teknisyeninin) telgraf çekerek anlaşmaya çalışmasına benzer. Fotoğrafçı gördüğü resmi edebiyatçıya mektupla anlatır; ancak "resmin sağ altındaki leke" derken o lekenin tam rengini ve dokusunu kelimelere dökemez (buna Bilgi Darboğazı / Information Bottleneck diyoruz).
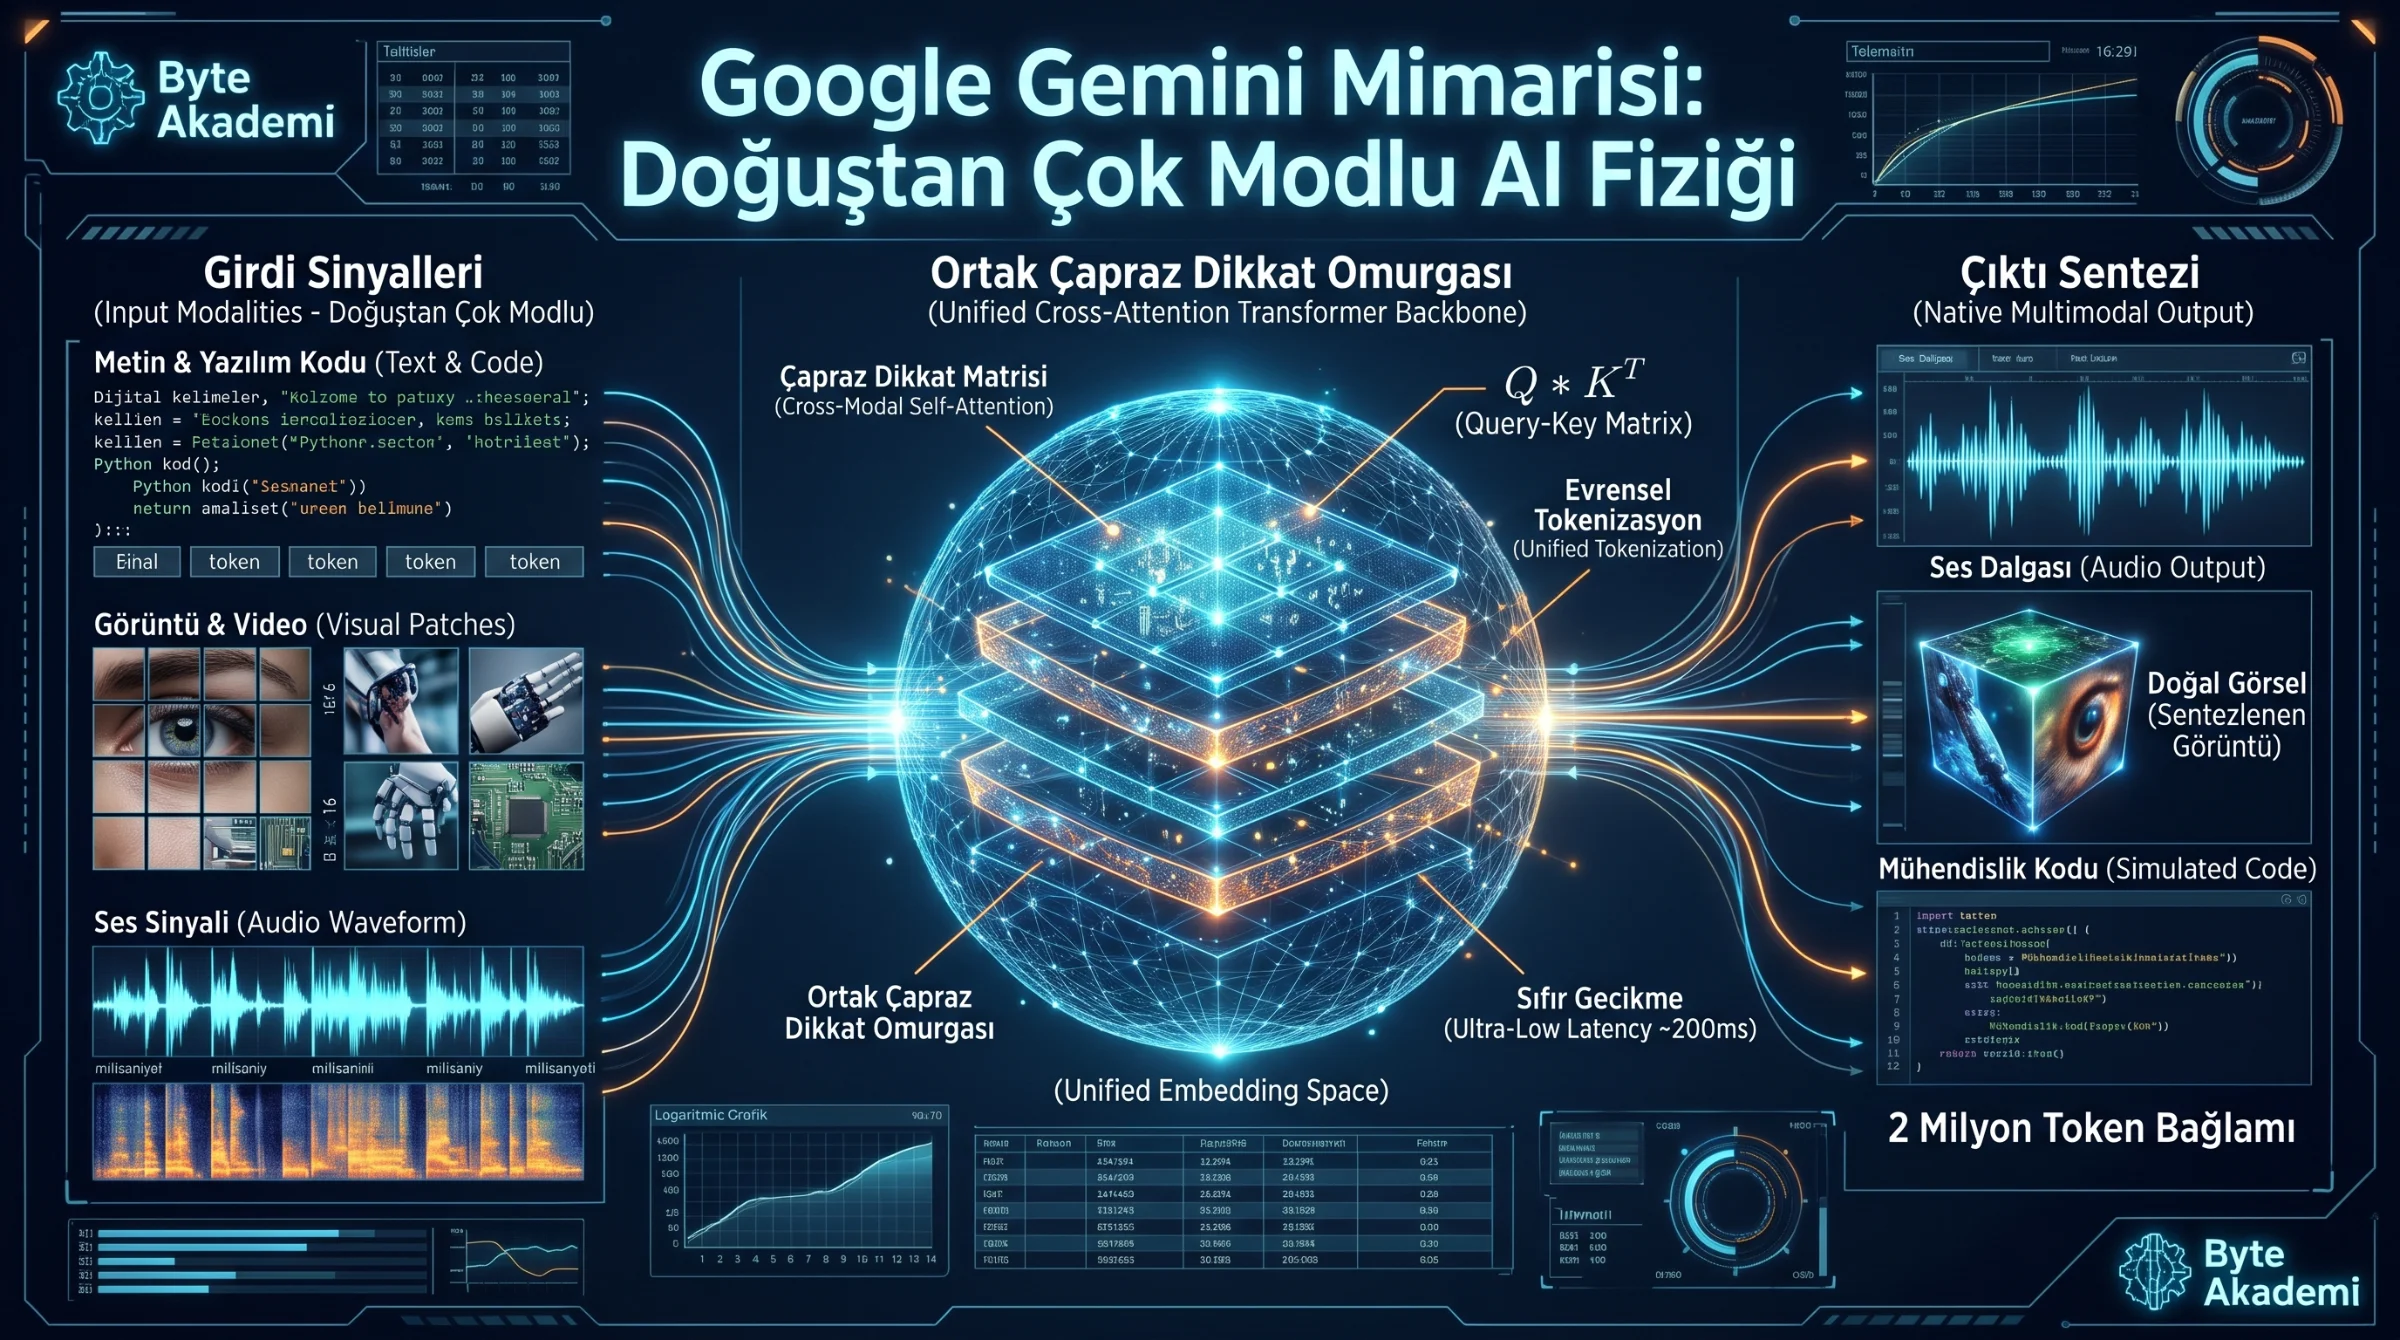
Google Gemini ise doğduğu ilk günden (yani eğitimin 1. saniyesinden) itibaren metinleri, ses frekanslarını, görüntü piksellerini, video karelerini ve yazılım kodlarını tek bir ortak sinir ağı omurgası (Unified Transformer Backbone) içinde öğrendi! Yani Gemini için Türkçe bir cümledeki "Şimşek" kelimesi ile, bir videodaki parlayan şimşek pikselleri ve ses dosyasındaki gök gürültüsü frekansı ayrı dünyaların verileri değildir; hepsi aynı çok boyutlu matematiksel uzayın (Ortak Gömme Uzayı / Joint Embedding Space) tam merkezinde üst üste binmiş kardeş vektörlerdir!
  [ESKİ NESİL "YAMALI" (CASCADED) AI vs. GOOGLE GEMINI "DOĞUŞTAN ÇOK MODLU" MİMARİ]

  A) ESKİ YÖNTEM (Ayrı Modüller -> Veri ve Duygu Kaybı!):
  [Ses Dalgaları] ---> (Whisper/STT) ---> "Düz Metin" ---+
  [Fotoğraf/Video] --> (CLIP/ViT)   ---> "Resim Özeti" -+--> [SADECE METİN LLM] --> Yanıt
                                                             (Tonlama ve mikro-piksel kayboldu!)

  B) GOOGLE GEMINI (Natively Multimodal -> Tek Ortak Beyin!):
  [Metin & Kod]   ---> Token_Text  ---+
  [Ses Spektrumu] ---> Token_Audio ---+--> [ORTAK ÇAPRAZ DİKKAT (CROSS-ATTENTION) OMURGASI]
  [Görüntü/Video] ---> Token_Vis   ---+           |
v (Ayrık Ses, Görsel ve Metin Token Çıktısı!)Eski bir sisteme sesli olarak alaycı (ironik) bir ses tonuyla "Harika, trafo yine patladı!" dersen, ses-metin çeviricisi bunu düz yazı olarak "Harika, trafo yine patladı" diye çevirir ve yapay zeka "Harika" kelimesini görüp seni tebrik etmeye kalkar! Oysa Gemini senin sesini yazıya çevirmeden doğrudan ses dalgası tokenı (USM - Universal Speech Model) olarak dinlediği için sesindeki stresi, frekans titremesini ve ironiyi anında kavrar!
Google Gemini için bir cümledeki 'şimşek' kelimesi, videodaki parlayan şimşek pikselleri ve sesteki gök gürültüsü frekansı ayrı dünyaların verileri değildir; hepsi tek bir ortak vektör uzayında çarpılan kardeş matematiksel jetonlardır.
2. Kaputun Altındaki Matematik: Pikseller, Sesler ve Kelimeler Aynı Denklemde Nasıl Çarpılır?
Peki dostum, bilgisayar bilimi açısından düşünelim: Bir metin "harflerden" oluşur, bir fotoğraf "RGB renk matrislerinden" oluşur, bir ses ise "zamana bağlı basınç dalgalarından (Hz)" oluşur. Elma ile armudu bile toplayamazken, Gemini bu üç farklı fiziksel büyüklüğü aynı denklemin içine nasıl sokuyor? İşte sırrımız: Evrensel Tokenizasyon (Birleşik Jetonlaştırma) ve Çapraz Dikkat (Cross-Modal Attention)!
- Görüntü ve Videonun Parçalanması (ViT Patch Tokenization): Gemini bir fotoğrafa veya video karesine baktığında onu 16x16 piksellik küçük karelere (Visual Patches) böler. Her bir küçük kareyi düzleştirip (flattening) tıpkı bir kelimeymiş gibi d-boyutlu bir sayı dizisine (vektöre) dönüştürür. Videolarda ise bu kareler zaman damgasıyla arka arkaya dizilerek uzay-zaman (spatio-temporal) dizisi oluşturur.
- Sesin Spektrogram Tokenlarına Dönüşümü: Ses dosyaları 16 kHz örneklemeyle milisaniyelik dilimlere ayrılır ve Mel-Spektrogram (frekans-zaman-genlik haritası) üzerinden ayrık ses tokenlarına (Discrete Audio Tokens) kodlanır.
- Birleşik Çapraz Dikkat Matrisi (Unified Self & Cross-Attention): Metin tokenları (Xtext), görüntü tokenları (Xvis) ve ses tokenları (Xaud) uç uca eklenerek tek bir dev matris (Xtotal) haline getirilir. Ardından Transformer mimarisinin kalbi olan Q (Sorgu - Query), K (Anahtar - Key) ve V (Değer - Value) matris çarpımına girer!
// GOOGLE GEMINI BİRLEŞİK ÇOK MODLU DİKKAT (UNIFIED MULTIMODAL ATTENTION) DENKLEMİ

// 1. Farklı Fiziksel Girdilerin Ortak Vektör Uzayına (R^d) İzdüşümü:
Z_joint = Concat( E_text(Text), E_vis(Image_Patches), E_aud(Audio_Frames) ) + P_pos

// 2. Birleşik Vektör Matrisi Üzerinde Çapraz Dikkat (Cross-Attention) Hesabı:
Attention(Q, K, V) = Softmax( ( Q * K^T ) / sqrt(d_k) + M_causal ) * V

// Burada Sorgu (Q), Anahtar (K) ve Değer (V) Doğrudan Birleşik Uzaydan Üretilir:
Q = Z_joint * W_Q  |  K = Z_joint * W_K  |  V = Z_joint * W_V

Z_joint   : Metin, Görüntü ve Ses Tokenlarının Uç Uca Eklendiği Birleşik Matris
P_pos     : 2D Uzamsal (Görüntü) ve Zamansal (Video/Ses) Konum Kodlaması (RoPE)
Q * K^T   : Bir Kelimenin, Görüntüdeki Hangi Piksele ve Sesteki Hangi Tonlamaya
            Odaklanacağını Hesaplayan Skaler Çarpım Matrisi!
sqrt(d_k) : Gradyan Patlamasını Önleyen Ölçekleme Faktörü
Yukarıdaki denklemde yer alan Q * K^T çarpımının ne anlama geldiğini fark ettin mi? Sen Gemini'ye bir elektrik panosu fotoğrafı yükleyip "Şu sağdaki yanık klemens hangi faza ait?" diye sorduğunda; cümlendeki "yanık klemens" kelimesinin Sorgu (Q) vektörü, doğrudan fotoğrafın içindeki siyahlaşmış piksel karesinin Anahtar (K) vektörüyle çarpılır ve aralarındaki açı sıfıra yaklaştığı için (Kosinüs Benzerliği = 1) model tam olarak o piksele odaklanır!
3. Üç Farklı Mimari Karşılaştırması: Sadece Metin vs. Yamalı Modeller vs. Google Gemini
Mühendislik projelerinde veya günlük iş akışında neden doğuştan çok modlu bir mimarinin diğerlerine göre ezici bir üstünlük sağladığını aşağıdaki karşılaştırma tablosunda net olarak görebilirsin:
| Mühendislik ve Performans Kriteri | Klasik Dil Modelleri (Sadece Metin LLM) | Sonradan Yamalı Çok Modlu Sistemler (Cascaded AI) | Google Gemini Mimarisi (Natively Multimodal) |
|---|---|---|---|
| Eğitim Omurgası (Pre-Training) | Yalnızca metin ve kod dizileriyle eğitilir. | Ayrı modeller eğitilip sonradan adaptörle birbirine bağlanır. | İlk günden itibaren metin, görüntü, ses ve video ile ortak eğitilir! |
| Ses İşleme ve Anlama Fiziği | Sesi hiç duyamaz (Harici STT gerekir). | Sesi önce düz yazıya çevirir; tonlama, duygu ve vurgu kaybolur. | Sesi doğrudan dalga formu (Native Audio) olarak dinler; tonlamayı anlar. |
| Video ve Zaman Algısı | Videoyu okuyamaz (Sadece altyazıyı okur). | Videodan tek tük fotoğraf karesi çekip metne çevirmeye çalışır. | Binlerce video karesini ve ses kanalını senkronize vektör olarak okur. |
| Tepki Süresi (Latency / Gecikme) | Metinde hızlıdır (~300 ms). | Yavaştır (Ses -> Metin -> LLM -> Ses zinciri 2-4 saniye sürer). | Ultra Hızlıdır (~200 - 300 ms gerçek zamanlı çift yönlü akış). |
| Teknik Diyagram ve Şema Okuma | Okuyamaz. | Yüzeysel okur; ok yönlerini ve ince kesişimleri sıkça karıştırır. | Mekansal koordinat kilidiyle devre şeması ve grafiklerde %95+ isabet. |
4. Uzamsal-Zamansal (Spatio-Temporal) Algı ve "Ayrık Görsel/Ses Üretimi"
Gemini mimarisinin en büyüleyici yanlarından biri sadece çok modlu veri okuması (Input) değil, aynı zamanda çok modlu veri üretebilmesidir (Native Multimodal Output)! Model, tek bir akıl yürütme zinciri içinde hem açıklayıcı metni yazar, hem Imagen 3 / ayrık görüntü jetonlarıyla şemayı çizer, hem de doğrudan kendi ses tellerinden (doğal ses sentezleyici tokenlarıyla) seninle konuşur.
1. Uzun Metin Yazmak Yerine "Görsel + Kısa Komut" Ver: Karmaşık bir Excel tablosunu, hata veren bir yazılım ekranını veya bir OG trafo etiketini satır satır yazarak anlatmaya çalışma! Doğrudan ekran görüntüsünü veya fotoğrafını çekip Gemini'ye at; "Bu etiketteki kısa devre empedansı (%Uk) ve bağlantı grubuna göre sekonder kısa devre akımını hesapla" de. Görsel tokenlar metinden çok daha net bağlam kurar!
2. Görüntü Üzerine Kırmızı Ok veya Kutu Çiz (Visual Prompting): Gemini'ye çok kalabalık bir teknik çizim veya devre kartı fotoğrafı yüklerken, sormak istediğin parçanın etrafını telefonunda kırmızı kalemle yuvarlak içine al ve "Kırmızı daire içindeki komponentin görevi nedir?" diye sor. Çapraz dikkat (Cross-Attention) matrisi doğrudan o kırmızı piksellere kilitlenir!
3. Ses, Görüntü ve Kodu Aynı İstemde Birleştir: Bir web sitesi veya arayüz tasarlarken kağıda tükenmez kalemle kaba bir taslak çiz, fotoğrafını çekip yükle ve "Bu kağıttaki el çizimimi modern, koyu siber temalı, mobil uyumlu tek parça bir HTML/CSS/JS koduna dönüştür" komutunu ver. Saniyeler içinde çalışan kodun hazır!
5. İnternette İlk Kez: Gemini'nin Çok Modlu Çapraz Dikkatini Ateşleyen 3 "Master Prompt"
Gemini'nin sıradan bir sohbet botu olmadığını kendi gözlerinle test etmek istiyorsan, aşağıdaki 3 çok modlu (Multimodal) senaryoyu kopyalayıp hemen dene:
// SENARYO 1 — [MÜHENDİSLİK ŞEMASI & ARIZA TEŞHİS PROMPTU]:
(Ek: Bir elektrik panosu, PCB devre kartı veya tek hat şeması fotoğrafı yükle)
Prompt:
"Bu görseldeki sistemi doğuştan çok modlu (native multimodal) görsel-mekansal analizle incele.
1. Görseldeki tüm ana bileşenleri sol üstten sağ alta doğru koordinatlarıyla listele.
2. Bağlantı noktalarında, kablo renklerinde veya şema sembollerinde standartlara (IEC/IEEE) aykırı bir anomali veya potansiyel arıza riski var mı?
3. Sonucu teknik bir tablo halinde sun."

// SENARYO 2 — [EL YAZISI FORMÜLÜ KOD VE SİMÜLASYONA DÖNÜŞTÜRME PROMPTU]:
(Ek: Deftere el yazısıyla yazdığın bir matematik/fizik denkleminin fotoğrafını yükle)
Prompt:
"Fotoğraftaki el yazısı matematiksel denklemi oku.
1. Önce bu denklemi hatasız bir şekilde dijital formata çevir ve her değişkenin fiziksel anlamını açıkla.
2. Ardından bu denklemi farklı sınır koşulları altında çözen ve sonucu grafik olarak çizen temiz bir Python (NumPy/Matplotlib) kodu yaz."

// SENARYO 3 — [VİDEO VE SES EŞZAMANLI ANALİZ PROMPTU]:
(Ek: Bir makinenin çalışma videosunu veya bir teknik sunum videosunu yükle)
Prompt:
"Yüklediğim bu videoyu hem görüntü kareleri (görsel akış) hem de ses frekansı boyutuyla eşzamanlı analiz et. Dakika ve saniye (MM:SS) damgaları vererek; videodaki en kritik 5 teknik olayı, ekranda beliren grafikleri ve konuşmacının vurguladığı anahtar parametreleri yapılandırılmış bir özet tablosuna dönüştür."
6. Sıkça Sorulan Sorular (Google Gemini Mimarisi Hakkında Merak Edilenler)
1. Gemini'ye yüklediğim bir fotoğraf veya PDF belgesi hafızada kaç "Token" yer kaplar?
Gemini'nin görsel kodlayıcısı (Visual Tokenizer) son derece verimlidir: Standart bir fotoğraf yaklaşık 258 Token, bir PDF belgesinin her bir sayfası (içindeki grafikler ve tablolar dahil) ortalama 258 Token, bir ses dosyasının her saniyesi yaklaşık 32 Token ve bir videonun her saniyesi (görüntü + ses birlikte) yaklaşık 290 ila 300 Token yer kaplar. Bu sayede milyonlarca tokenlık bağlam penceresine binlerce sayfa belge veya saatlerce video sığdırabilirsin!
2. Gemini bir fotoğrafın içindeki çok küçük yazıları okurken OCR (Optik Karakter Tanıma) eklentisi mi kullanıyor?
Hayır! Harici bir OCR programına ihtiyaç duymaz. Görüntüyü yüksek çözünürlüklü ızgara parçalarına (High-Res ViT Patches) bölerek doğrudan kendi sinir ağı katmanlarında okur. Bu sayede eğri büğrü yüzeylerdeki, paslı metal etiketlerdeki veya doktor el yazısı kadar karmaşık notlardaki yazıları bile bağlamdan çıkararak hatasız okur.
3. "Gemini" isminin bu mimariyle özel bir bağlantısı var mı?
Evet! Latincede "İkizler" anlamına gelen Gemini ismi; hem Google'ın iki efsanevi yapay zeka araştırma ekibi olan Google Brain ve DeepMind'ın güçlerini tek bir çatı altında birleştirmesini, hem de NASA'nın Ay'a iniş programı Apollo'dan hemen önce uzayda kenetlenme testlerini başarıyla gerçekleştiren Project Gemini uzay programını (metin ile görsel/ses dünyalarının tek bir uzayda kenetlenmesini) simgeler.