Selam yapay zeka ve mühendislik tutkunu dostum! Sana son üç yıldır internetteki bütün "Prompt Mühendisliği" eğitimlerinde, YouTube videolarında ve sosyal medya paylaşımlarında papağan gibi tekrarlanan o meşhur altın kuralı hatırlatayım: "Yapay zekadan daha zeki bir yanıt almak istiyorsanız, cümlenizin sonuna mutlaka 'Lütfen adım adım düşün (Think step-by-step)' yazın!" Hatta hepimiz bunu o kadar alışkanlık haline getirdik ki, artık yapay zekaya basit bir kod veya matematik sorusu sorarken bile parmaklarımız otomatik olarak bu sihirli kelimeleri yazar oldu, değil mi?
Ancak sana çok çarpıcı bir mühendislik gerçeği açıklayayım: 2022–2024 yıllarının "Sistem 1 (Düşünmeden Konuşan)" eski nesil dil modellerinde hayat kurtaran bu yöntem, Google Gemini 3.1 Pro gibi doğuştan "Sistem 2 (İçsel Akıl Yürütme / Native Reasoning)" mimarisine sahip yeni nesil modellerde artık sadece gereksiz olmakla kalmıyor; aynı zamanda modelin zeka kapasitesini kısıtlıyor, yanıt süresini ikiye katlıyor ve API faturanı gereksiz yere şişiriyor! Peki neden bir akıl yürütme modeline "adım adım düşün" demek, usta bir satranç büyükustasının kulağına eğilip "Bak, önce taşların yerini gör, sonra hamleni yap" diyerek dikkatini dağıtmaya benzer? Gel kahveni al; internette ilk kez tüm matematiksel kanıtlarıyla "Çift Düşünce Döngüsü Tuzağı"nı (Double-CoT Trap) ve bunun yerine kullanman gereken 3 Altın C-B-V (Kısıt-Sınır-Doğrulama) Şablonunu birlikte inceleyelim!
1. Eski "Adım Adım Düşün" (Zero-Shot CoT) Hilesi Neden İcat Edilmişti ve Neden Öldü?
Kojima ve arkadaşlarının 2022 yılında yayınladığı o ünlü makalede, eski nesil dil modellerine "Let's think step by step" dendiğinde matematik sorularındaki başarının %17'den %78'e fırladığı keşfedilmişti. Peki neden? Çünkü eski modellerin (erken dönem GPT-3.5/4 veya standart LLM'lerin) içinde gizli bir düşünme odası (Hidden Scratchpad) yoktu! Model soruyu görür görmez cevabı doğrudan senin ekranına yazmak zorundaydı. Sen ona "adım adım düşün" dediğinde, model ekrana sesli olarak ara işlemleri yazıyor ve kendi yazdığı o cümleleri okuyarak bir sonraki adımı tahmin ediyordu.
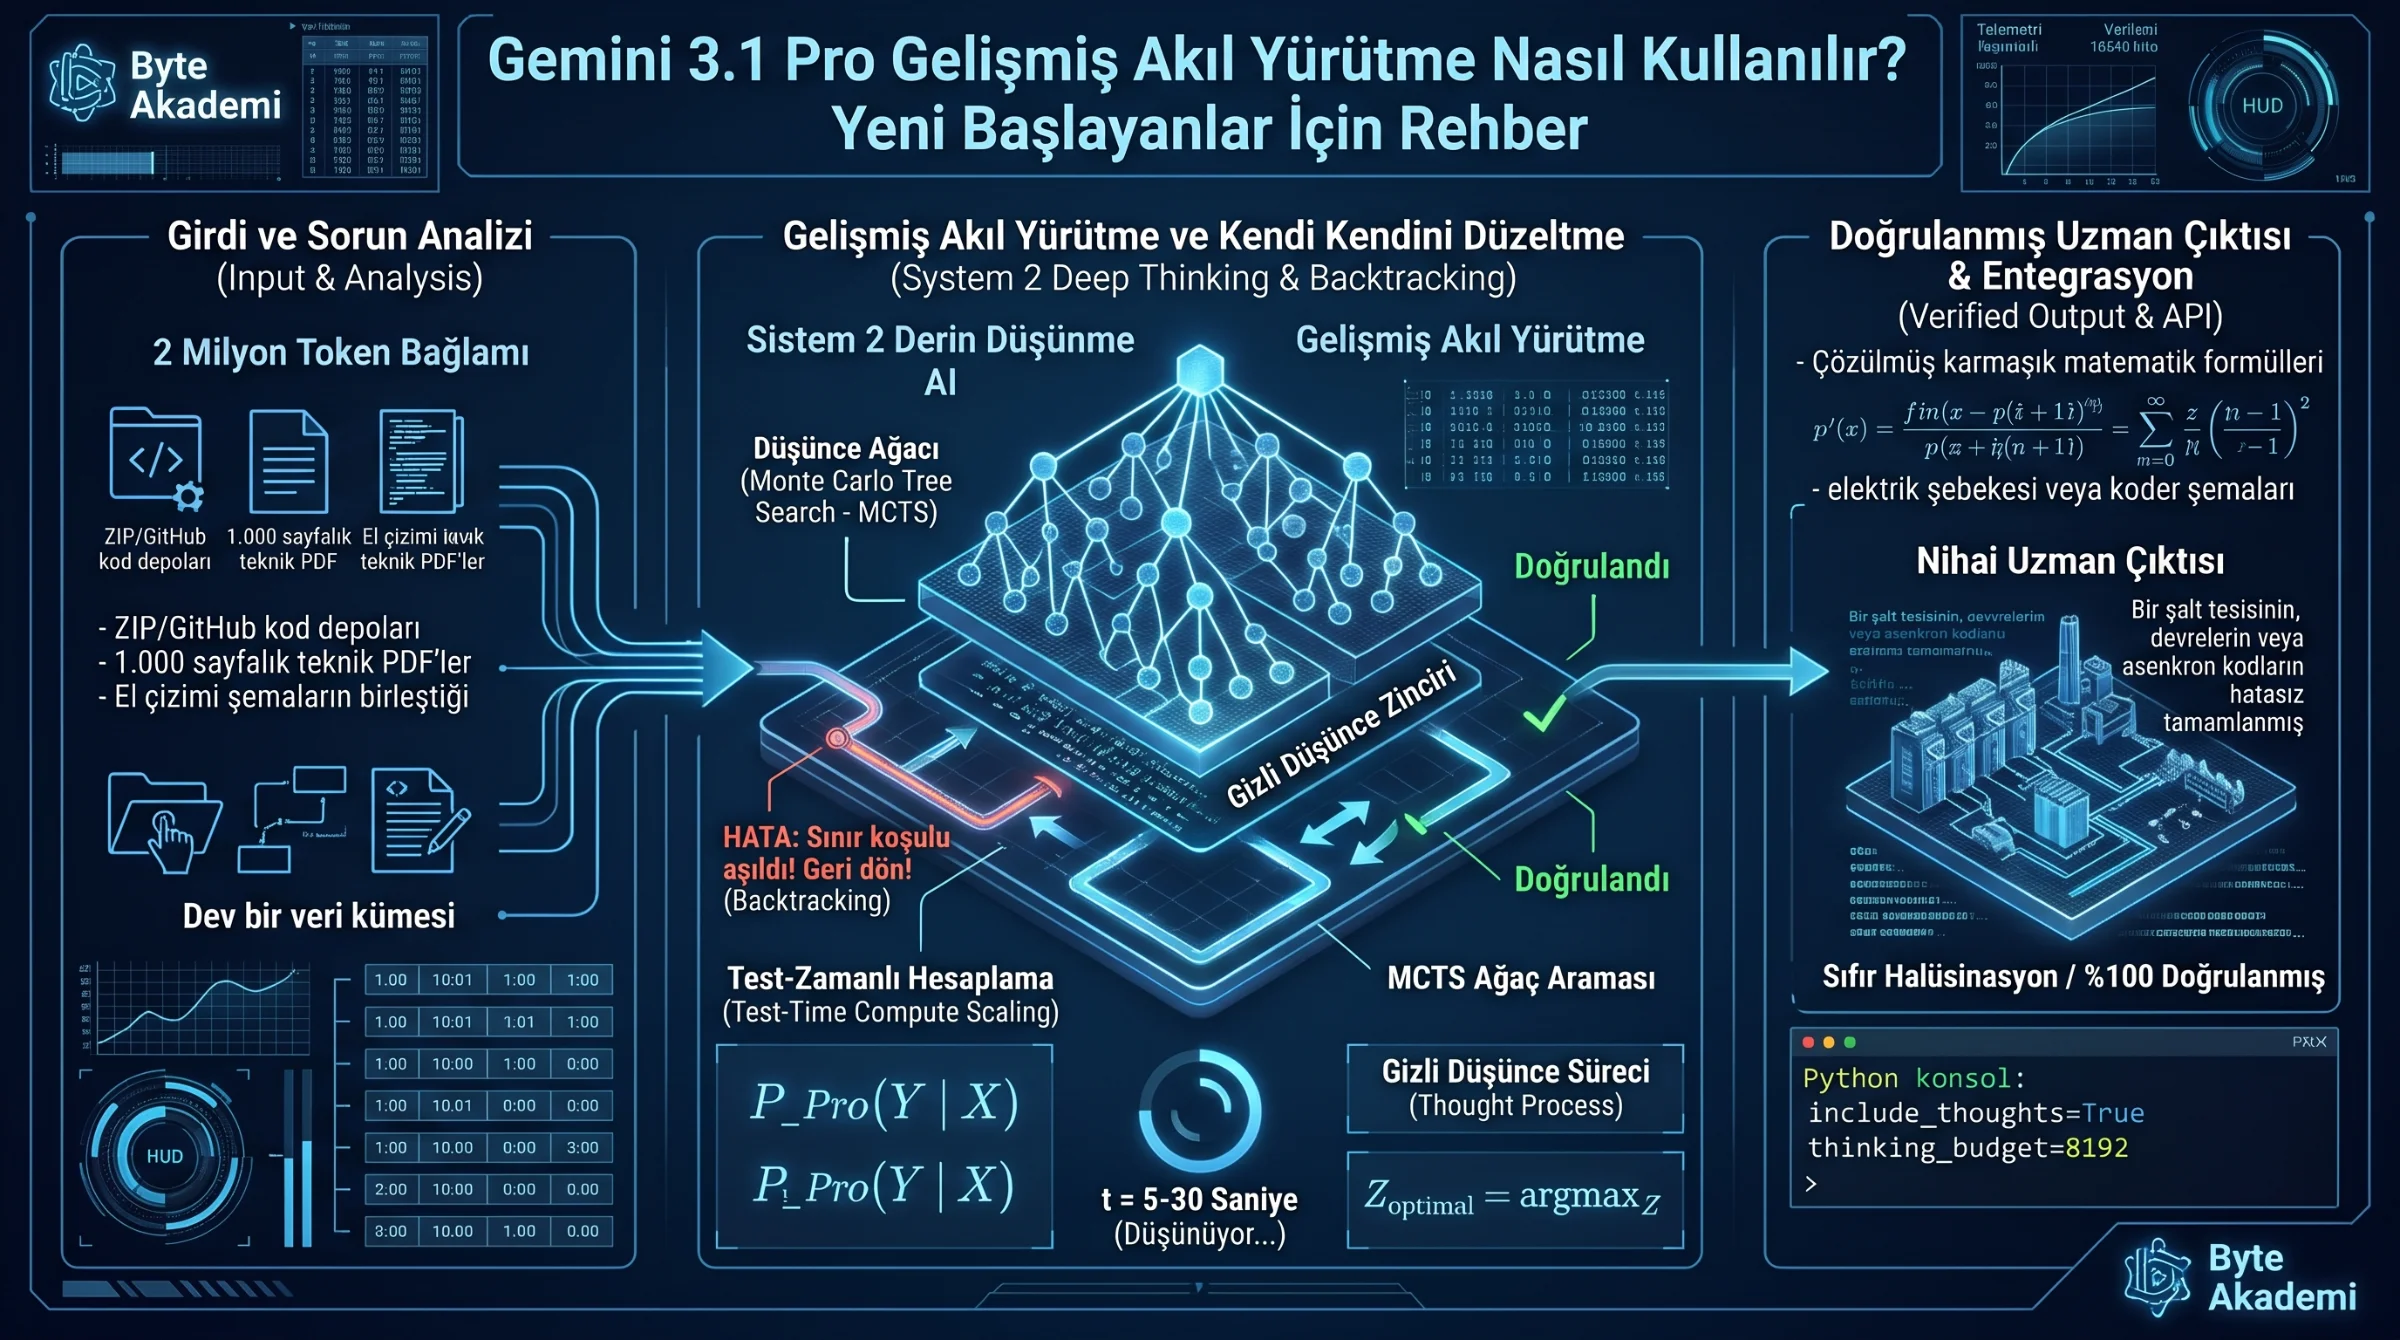
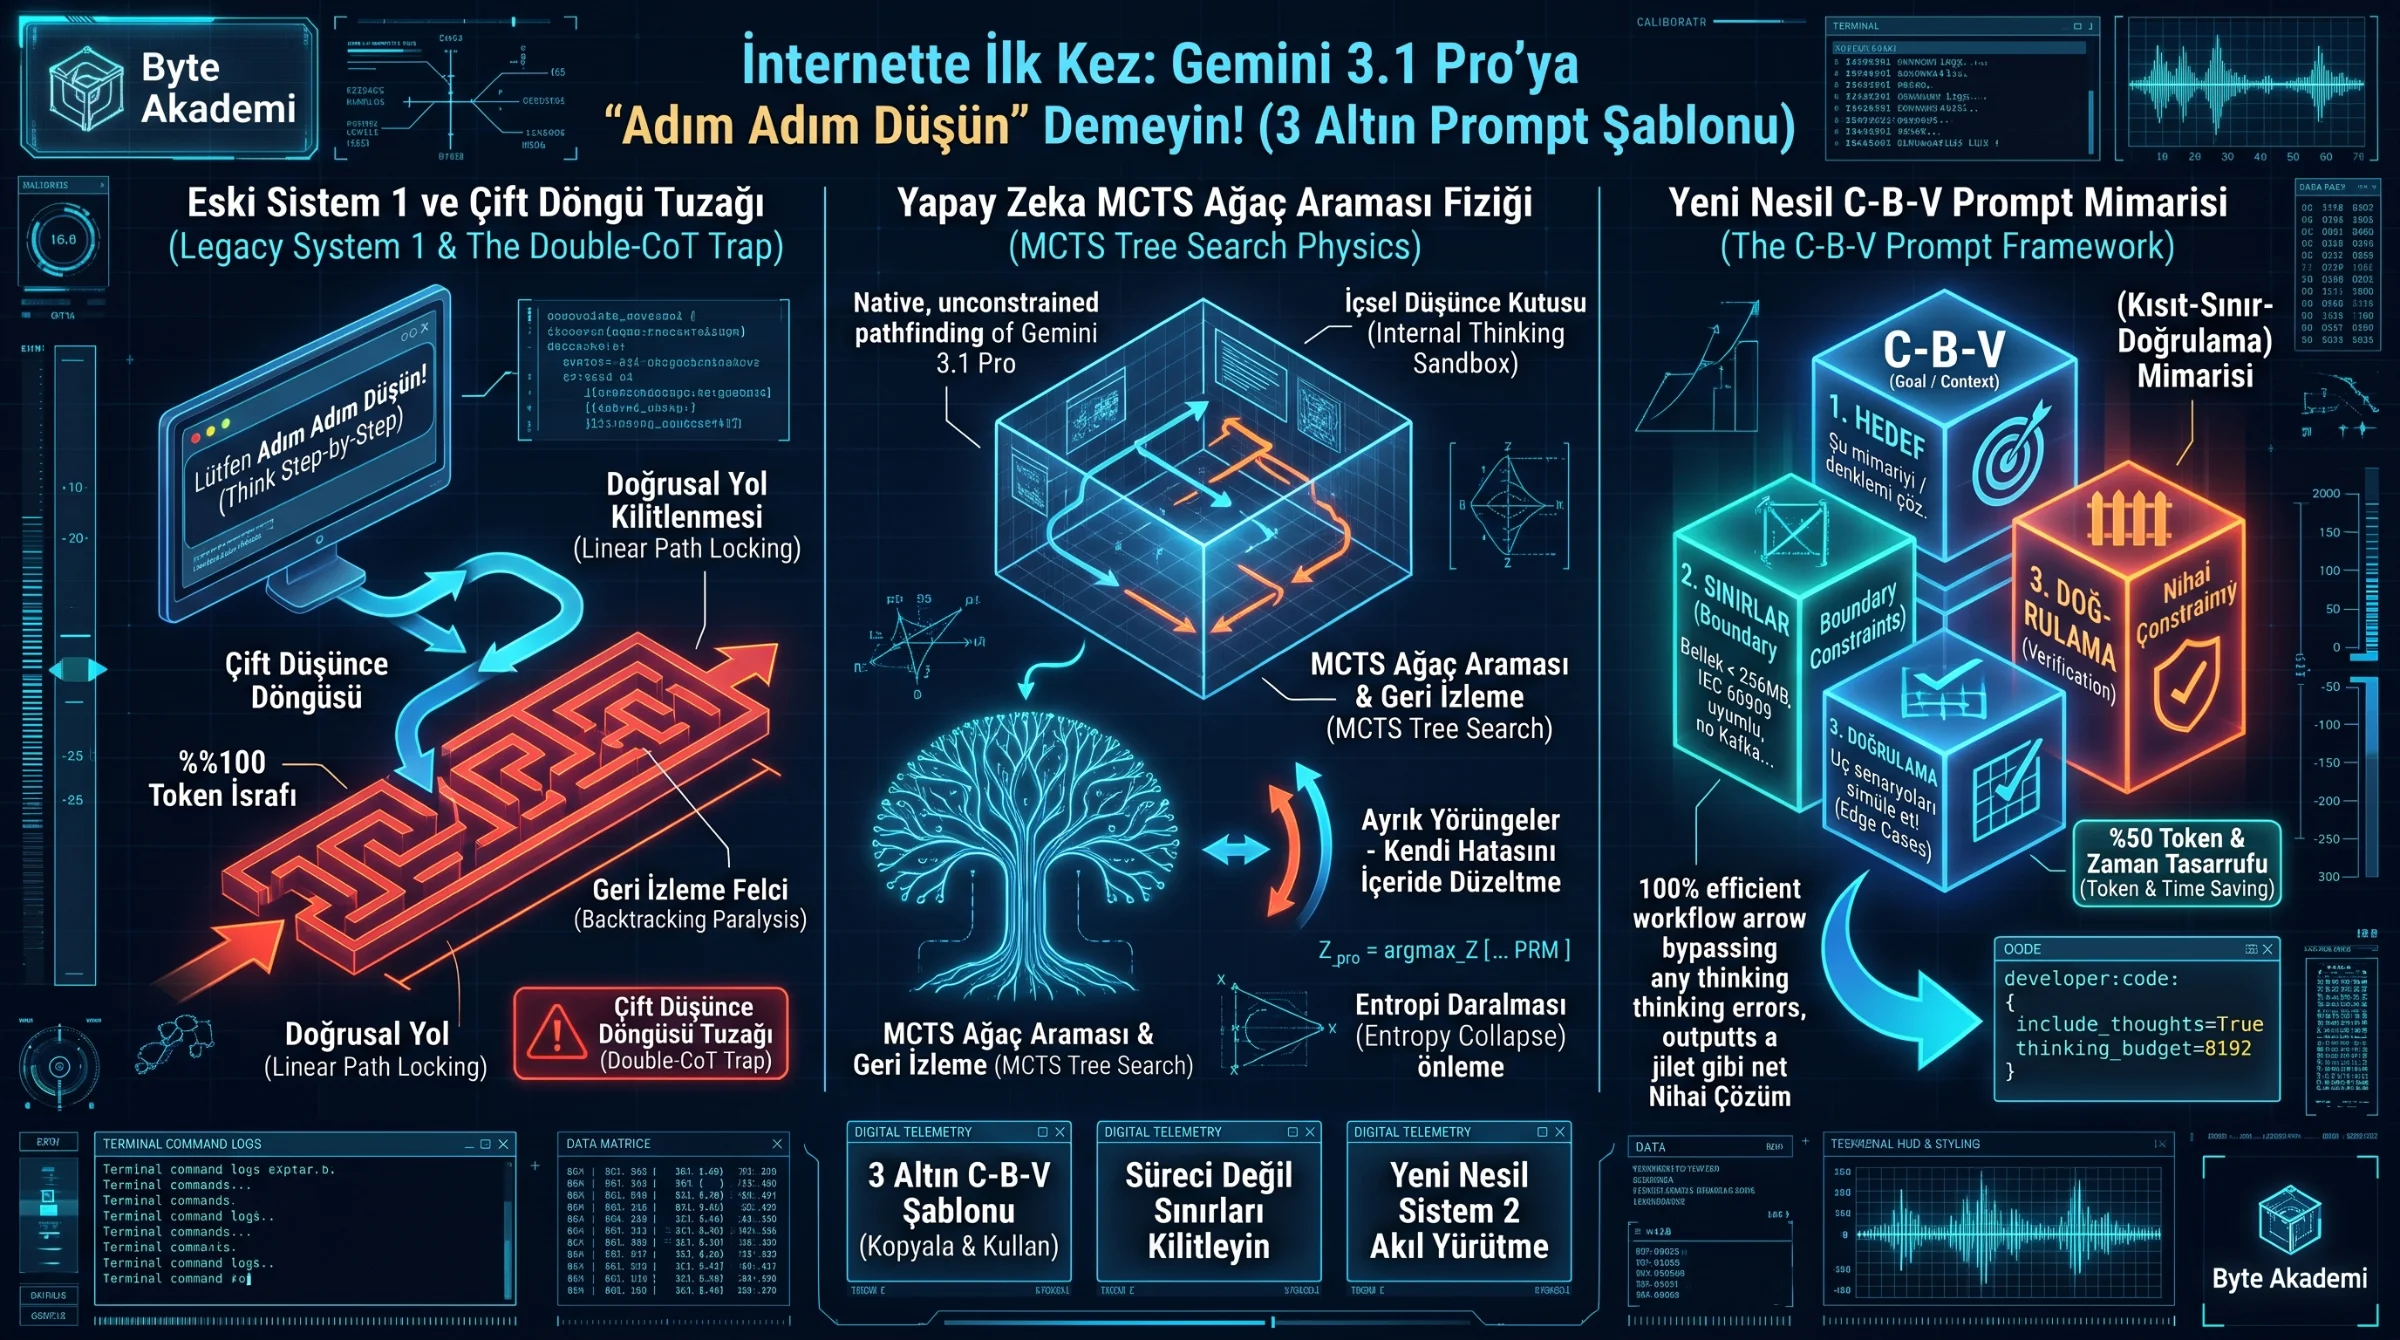
Oysa Gemini 3.1 Pro'nun mimarisi tamamen farklıdır! Sen soruyu gönderdiğin salisede, model ekrana tek bir harf bile basmadan önce arka planda donanımsal olarak kilitlenmiş özel bir Düşünce Kutusu (Internal Thinking Sandbox) açar. Orada zaten binlerce token boyunca kendi kendine adım adım düşünür, Monte Carlo Ağaç Araması (MCTS) yapar, yanlış gittiği yollardan geri döner (Backtracking) ve doğrulanmış sonucu bulur.
Eğer sen kalkıp Gemini 3.1 Pro'ya dışarıdan bir de "Adım adım düşün ve her adımı bana anlat" dersen arka planda şu 3 büyük mühendislik felaketi yaşanır:
- Çift Düşünce Döngüsü (Redundant Double-Loop) ve %100 Token İsrafı: Model önce gizli düşünce kutusunda 4.000 token harcayarak problemi çözer; ardından senin "adım adım yaz" emrine uymak için aynı düşünce sürecini bir de çıktı ekranına 3.000 token olarak baştan yazar! Hem iki kat süre beklersin hem de iki kat API parası ödersin.
- Doğrusal İstem Zorlaması (Linear Path Forcing — Geri İzleme Felci): İşte en tehlikeli kısım budur! Gemini 3.1 Pro'nun en büyük gücü, içsel düşüncesinde "A yolunu denedim, çıkmaz sokak, geri dönüp B yolunu deniyorum" diyebilmesidir (Non-Linear Tree Search). Ama sen ona "Adım 1, Adım 2, Adım 3 şeklinde düşün" diye dayatma yaptığında, modelin içsel ağaç aramasını düz bir çizgiye (lineer yola) hapsedersin! Model ilk adımda yaptığı bir varsayımdan geri dönemez hale gelir.
- Erken Entropi Çöküşü (Premature Entropy Collapse): Model, problemi nasıl çözeceğine odaklanmak yerine "Acaba kullanıcının istediği 'adım adım' formatını nasıl güzel yazarım?" stresine girerek bilişsel kapasitesini formatlamaya harcar.
// MATEMATİKSEL KANIT: DOĞRUSAL DAYATMA (ESKİ CoT) vs. AĞAÇ ARAMASI (GEMINI 3.1 PRO)

// 1. Dışarıdan "Adım Adım Düşün" Dayatıldığında (Tek Yönlü Zincir - Geri Dönüş Yok!):
H_forced = Sum_t=1_to_k [ log P( Step_t | Step_1..t-1, "Adım_Adım_Kuralı" ) ]
(Eğer Step_2 hatalıysa, P(Doğru_Sonuç) -> 0'a çöker!)

// 2. Gemini 3.1 Pro Serbest Bırakıldığında (MCTS Ağaç Dallanması + Backtracking):
Z_pro = argmax_{T in Trees} [ Sum_{node in T} R_PRM(node) - KL_Div( P_model || P_prior ) ]

H_forced : Dışarıdan Zorlanan Doğrusal (Lineer) Düşünce Entropisi
Trees    : Modelin İçeride Aynı Anda Denediği Paralel Çözüm Ağaçları
R_PRM : Yanlış Dalı Anında Budayan (Pruning) Süreç Ödül DoğrulayıcısıBir Gemini 3.1 Pro modeline "Adım adım düşün" demek, otomatik vitesli bir Formula 1 aracına debriyaj pedalı takmaya çalışmaktır. Yeni nesil akıl yürütme modellerinde altın kural şudur: Süreci (nasıl düşüneceğini) tamamen modele bırak; sen sadece Hedefi, Sınır Koşullarını ve Test Kriterlerini kilitle!
Doğuştan akıl yürüten Gemini 3.1 Pro modeline 'adım adım düşün' diye komut vermek, otomatik vitesli bir Formula 1 aracına debriyaj pedalı takmaya benzer; modele nasıl düşüneceğini değil, hangi sınır koşullarını doğrulayacağını söyleyin.
2. Eski Prompt vs. Yeni Nesil "C-B-V (Kısıt-Sınır-Doğrulama)" Mimarisi
Peki "adım adım düşün" demeyeceksek ne diyeceğiz? Google DeepMind ve ileri seviye yapay zeka araştırmacılarının akıl yürütme (Reasoning) modelleri için geliştirdiği en güçlü metodoloji C-B-V (Context/Goal - Boundary Constraints - Verification Criteria) yani Hedef - Sınır Koşulları - Doğrulama Kriteri mimarisidir.
  [ESKİ NESİL PROMPT TUZAĞI vs. GEMINI 3.1 PRO "C-B-V" MİMARİSİ]

  A) YANLIŞ YÖNTEM (Eski Nesil "Mikro-Yönetim" Promptu):
  "Sen bir uzmansın. Şimdi derin bir nefes al ve adım adım düşün:
   Adım 1: Önce verileri oku. Adım 2: Formülü yaz. Adım 3: Hesapla..."
       |
       v  [SONUÇ: Modelin içsel MCTS ağacı kilitlenir, gereksiz laf kalabalığı üretilir!]

  B) DOĞRU YÖNTEM (Gemini 3.1 Pro "C-B-V" Mühendislik Kilidi):
  +-------------------------------------------------------------------+
  | 1. HEDEF (Goal)          : "Şu mimariyi / denklemi çöz."          |
  | 2. SINIRLAR (Boundaries) : "Bellek < 512MB, IEC 60909 uyumlu..."  |
  | 3. DOĞRULAMA (Verify)    : "Uç senaryolarda (Edge-Case) test et!" |
  +-------------------------------------------------------------------+
       |
       v  [SONUÇ: Model içeride 10 farklı yolu simüle eder, en kusursuz çözümü basar!]
3. Karşılaştırma Tablosu: Eski "CoT" Promptları vs. Yeni "C-B-V" Promptları
Kendi projelerinde geçiş yaparken farkı net görmen için hazırladığım mühendislik kıyaslama tablosu:
| Prompt Mühendisliği Kriteri | Eski Yöntem ("Adım Adım Düşün" / CoT) | Yeni Gemini 3.1 Pro Yöntemi (C-B-V Mimarisi) |
|---|---|---|
| Hedeflediği Yapay Zeka Mimarisi | Eski Sistem 1 Modelleri (Düşünme katmanı olmayanlar) | Sistem 2 Akıl Yürütme Modelleri (Gemini 3.1 Pro / Flash Thinking) |
| Model Üzerindeki Davranış Etkisi | Modeli tek bir düz çizgide (lineer) gitmeye zorlar. | Modelin içeride paralel hipotez ve geri izleme (Backtracking) yapmasını sağlar. |
| Örnek Verme (Few-Shot) Stratejisi | 3-5 adet uzun soru-cevap örneği yapıştırılır. | Sıfır Örnek (Zero-Shot) + Katı Sınır Koşulları (Örnekler yaratıcılığı kısıtlar!). |
| Token Maliyeti ve Yanıt Hızı | Yüksek Maliyet (İçeride ve dışarıda iki kez düşünür). | Optimum Maliyet (İçeride düşünür, dışarıya sadece saf çözümü basar). |
| Zorlu Mühendislik ve Kod Başarısı | %65 – %75 (İlk adımdaki hataya saplanıp kalır). | %94 – %98 (Kendi hatasını içeride yakalayıp düzelterek çıkar). |
4. İnternette İlk Kez: Gemini 3.1 Pro İçin 3 Altın "C-B-V" Prompt Şablonu (Kopyala & Kullan)
Artık "Adım adım düşün", "Derin bir nefes al", "Acele etme" gibi eski moda cümleleri tamamen çöpe atıyoruz! Onların yerine Gemini 3.1 Pro'nun içsel düşünce motorunu %100 kapasiteyle ateşleyen şu 3 Altın C-B-V Şablonunu doğrudan kopyalayıp kullanabilirsin:
// ALTIN ŞABLON 1 — [KUSURSUZ YAZILIM MİMARİSİ VE ALGORİTMA İNŞASI (C-B-V)]:
"HEDEF (GOAL):
[Projenin amacını 2 cümlede yaz. Örn: Yüksek frekanslı sensör verilerini (10k mesaj/sn) kayıpsız işleyen ve PostgreSQL'e toplu (batch) yazan bir Python mikro-servisi tasarla.]

SINIR KOŞULLARI VE KISITLAR (BOUNDARIES):
- Harici mesaj kuyruğu (Kafka/RabbitMQ) KULLANILMAYACAK; yalnızca yerel asenkron bellek (Asyncio Queue) ve disk yedeği kullanılacak.
- Maksimum RAM tüketimi 256 MB sınırını aşmamalı (Bellek sızıntısına karşı Backpressure mekanizması şart).
- Kod modüler, tip korumalı (Type-Hinted) ve doğrudan üretime hazır (Production-Ready) olmalı; 'TODO' veya eksik fonksiyon bırakılmamalı.

DOĞRULAMA KRİTERİ (VERIFICATION):
Nihai kodu ekrana yazmadan önce; içsel düşünme sürecinde 'Veritabanı bağlantısının 30 saniye koptuğu' ve 'Gelen veri hızının 2 katına çıktığı' iki uç senaryoyu (Edge-Case) simüle et. Gereksiz giriş cümlelerini atla ve doğrudan mimari şema + tam kodu ver."
// ALTIN ŞABLON 2 — [MÜHENDİSLİK HESABI, FİZİK VE ŞARTNAME DENETİMİ (C-B-V)]:
"HEDEF (GOAL):
[Mühendislik problemini yaz. Örn: 34.5 kV / 0.4 kV, 2000 kVA, %Uk=6 olan bir güç trafosunun OG ve AG tarafındaki maksimum simetrik kısa devre akımlarını ve dinamik tepe akımını (Ip) hesapla.]
SINIR KOŞULLARI VE KISITLAR (BOUNDARIES):
- Tüm hesaplamalar kesinlikle IEC 60909 standardındaki gerilim faktörlerine (c_max = 1.05 / 1.10) tam uyumlu olmalıdır.
- Şebeke besleme gücü (Sk'') 500 MVA ve R/X oranı 0.1 olarak kabul edilecektir.
- Yuvarlama hatalarını önlemek için ara değerlerde virgülden sonra en az 4 basamak korunmalıdır.
DOĞRULAMA KRİTERİ (VERIFICATION):
Yanıtı oluşturmadan önce tüm denklemlerin boyut analizini (birim kontrolünü) ve sayısal sağlamasını arka planda doğrula. Çıktıyı yalnızca: 1) Kullanılan Denklemler, 2) Parametre ve Sonuç Tablosu, 3) Seçilmesi Gereken Kesici/Bara Karakteristiği formatında sun."// ALTIN ŞABLON 3 — [ÇOKLU BELGE / KÖK NEDEN VE ÇELİŞKİ ANALİZİ (C-B-V)]:
(Ek: 2M Token Bağlamına PDF Şartnameleri, Hata Loglarını veya Kaynak Kodları Yükle)
"HEDEF (GOAL):
Yüklenen veri setindeki [sistem çökmesinin kök nedenini / belgeler arasındaki hukuki ve teknik çelişkileri] tespit et.
SINIR KOŞULLARI VE KISITLAR (BOUNDARIES):
- Yalnızca yüklenen belgelerdeki somut kanıtlara dayan; belgede olmayan hiçbir varsayımı (halüsinasyonu) analize dahil etme.
- Yüzeysel semptomları değil, birbirini tetikleyen zincirleme kök nedenleri (Root-Cause) bul.
DOĞRULAMA KRİTERİ (VERIFICATION):
İçsel akıl yürütme aşamasında bulduğun her bir iddiayı belgedeki tam [Dosya Adı, Sayfa/Satır Numarası] ile çapraz doğrula. Çıktıyı ciddiyet derecesine göre sıralanmış bir Mühendislik Denetim Tablosu olarak üret."1. "Sen 20 Yıllık Dünyanın En İyi Mühendisisin" Edebiyatını Bırak: Eski modellerde uzun rol yapma (Roleplay) paragrafları işe yarardı. Gemini 3.1 Pro'da ise 1 paragraf boyunca modeli övmek yerine çıktının teknik standardını belirtmek (Örn: "Yanıtları IEEE/IEC standartlarına ve MISRA-C kurallarına göre üret") 10 kat daha keskin sonuç verir!
2. Hazır "Few-Shot" Örneklerle Modelin Elini Kolunu Bağlama: Eğer Gemini 3.1 Pro'ya "Bak şu 3 örneğe, tıpkı bunlar gibi çöz" dersen, model kendi üstün ağaç araması algoritmasını kapatıp senin verdiğin basit örneği taklit etmeye çalışır. Örnek verme; sadece istediğin çıktı tablosunun sütun başlıklarını ver!
3. Negatif Emir Yerine Pozitif Sınır Koy: Modele "Sakın uzun yazma, sakın lafı uzatma" demek yerine "Her bölüm maksimum 3 madde ve 120 kelime ile sınırlandırılmıştır" şeklinde matematiksel sınır (Boundary) koy.
5. Sıkça Sorulan Sorular (Akıl Yürütme Modellerinde Prompt Mühendisliği)
1. Peki Gemini 3.5 Flash-Lite gibi küçük ve hızlı modellerde "Adım adım düşün" demeye devam etmeli miyim?
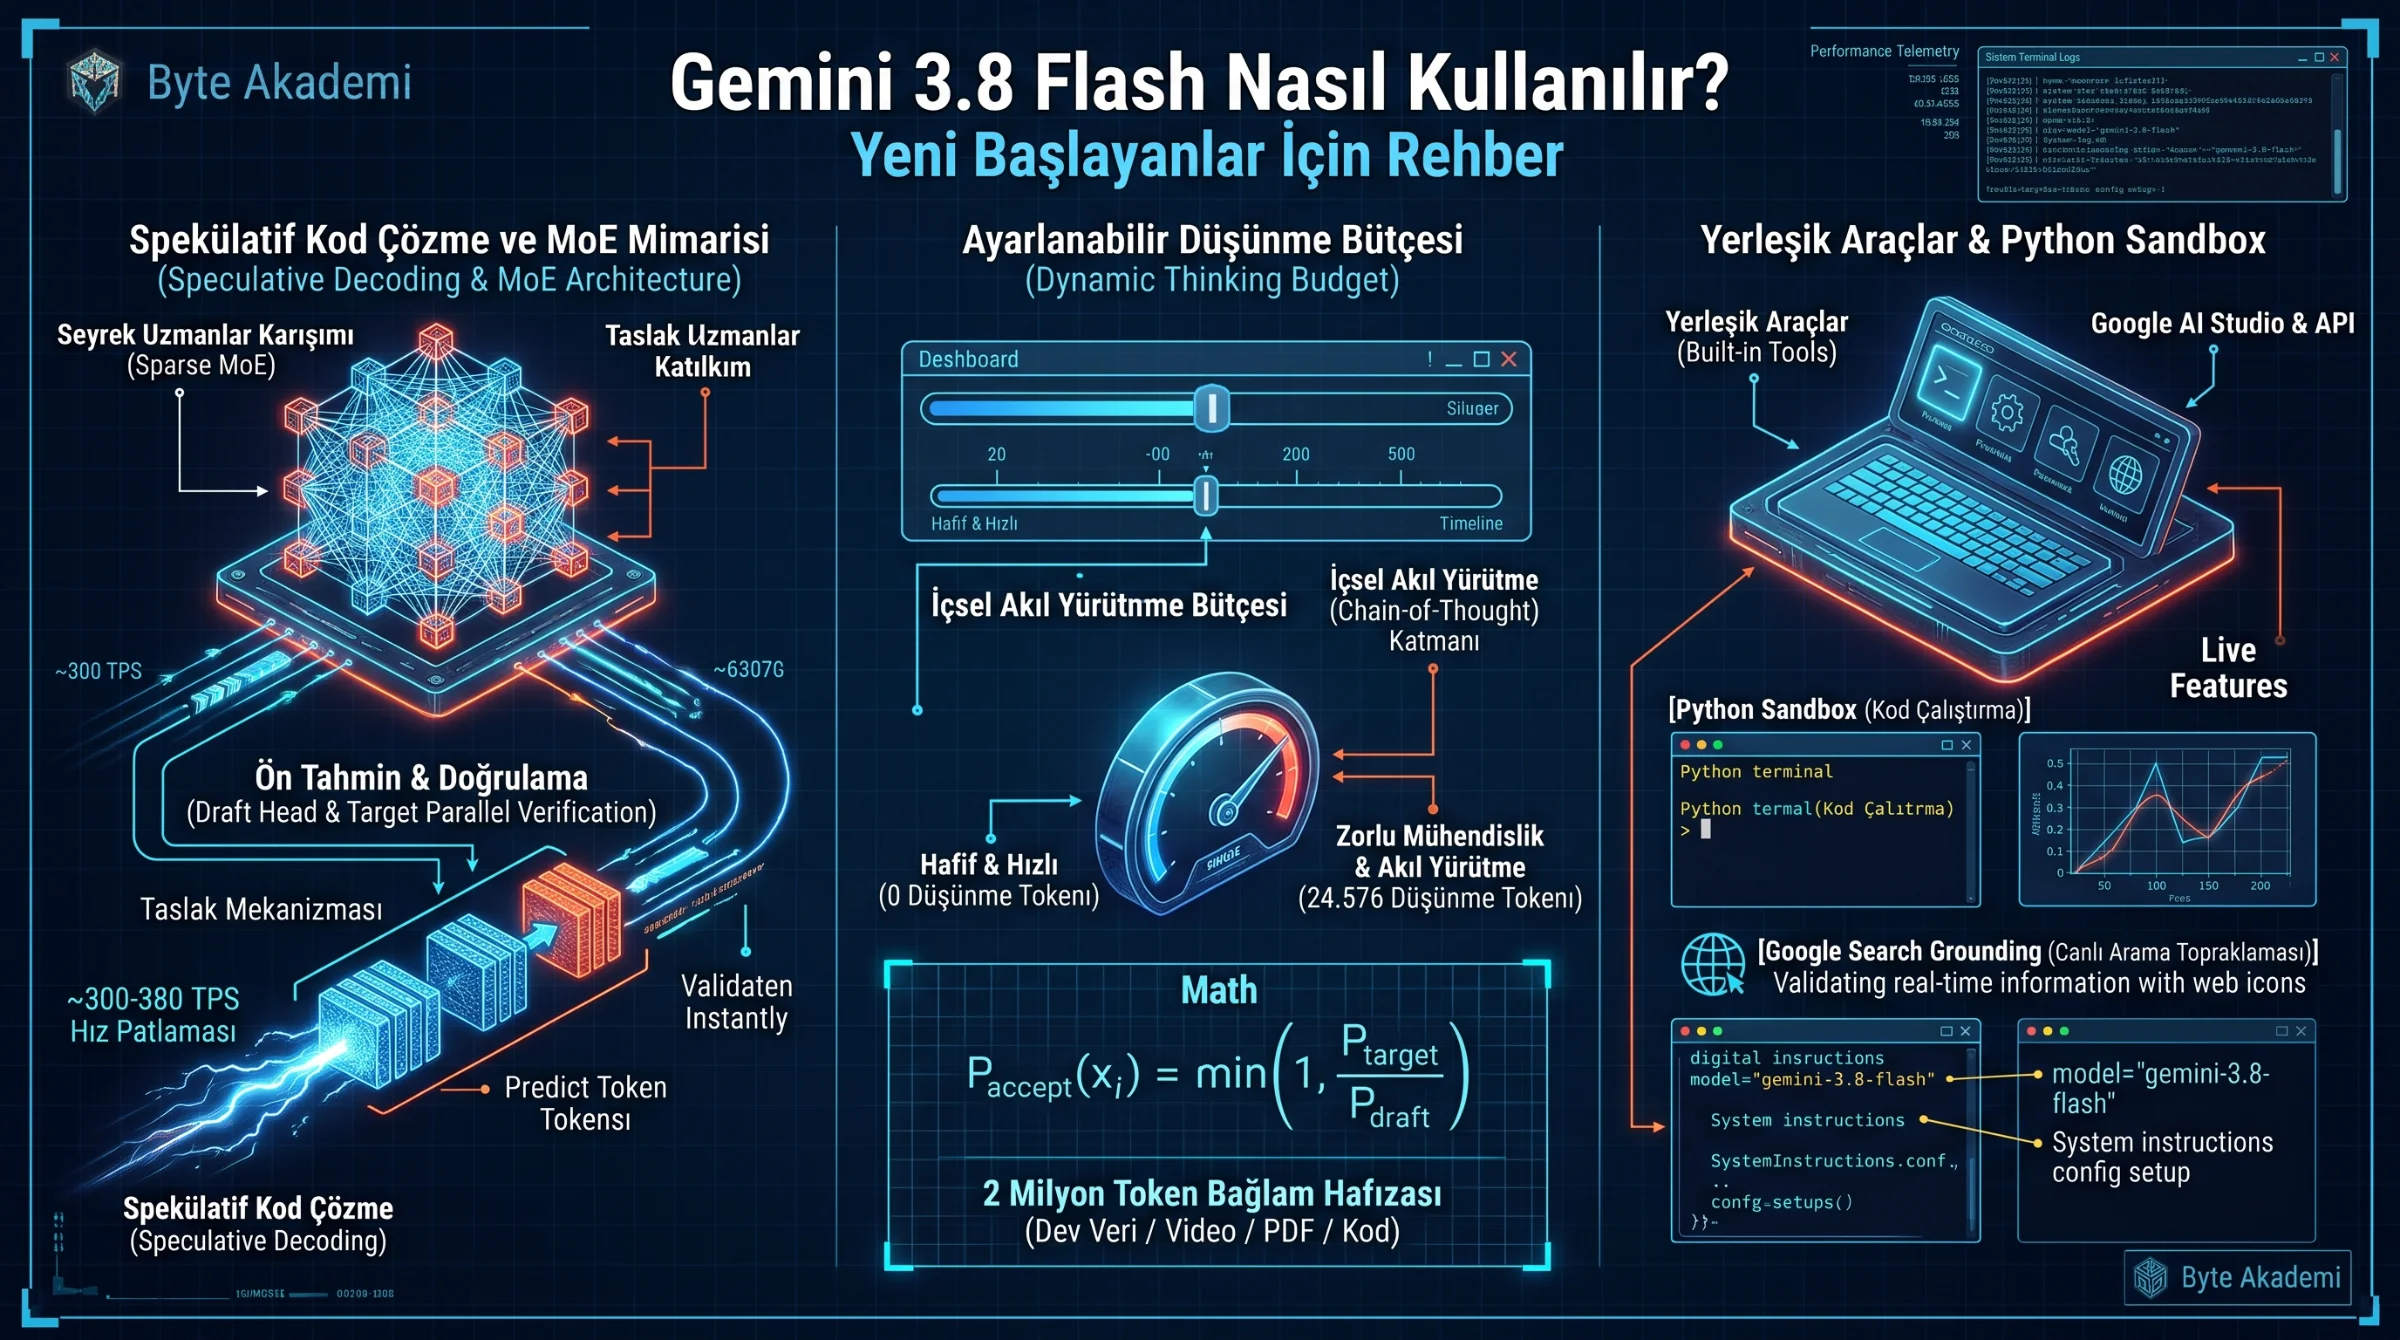
Evet, çok güzel bir nokta! Eğer düşünme katmanı kapalı (Thinking Budget = 0) olan ultra hızlı bir model (örneğin Gemini 3.5 Flash-Lite) kullanıyorsan ve ona bir matematik sorusu soruyorsan, onun gizli bir düşünme kutusu olmadığı için "Adım adım çöz" demek hala işe yarar! Ancak Gemini 3.1 Pro veya Thinking modu açık 3.8 Flash kullanıyorsan bunu asla yapmamalısın.
2. Modelin arka planda gerçekten düşünüp düşünmediğini nasıl anlarım?
Hem Gemini web arayüzünde hem de Google AI Studio'da yanıtın hemen üstünde "Düşünce sürecini göster (Thoughts)" açılır penceresi yer alır. Oraya tıkladığında modelin senin verdiğin C-B-V sınırlarını nasıl tek tek kontrol ettiğini ve kendi kendine nasıl tartıştığını canlı olarak okuyabilirsin.
3. API kullanırken modelin ne kadar derin düşüneceğini kodla sınırlayabilir miyim?
Kesinlikle! Python veya REST API üzerinden istek atarken thinking_config={"thinking_budget": 4096} parametresini kullanarak modelin içeride en fazla kaç token boyunca akıl yürüteceğini (1.024 ile 24.576 token arasında) projenin bütçesine göre tam olarak kilitleyebilirsin.